Pourquoi ce test
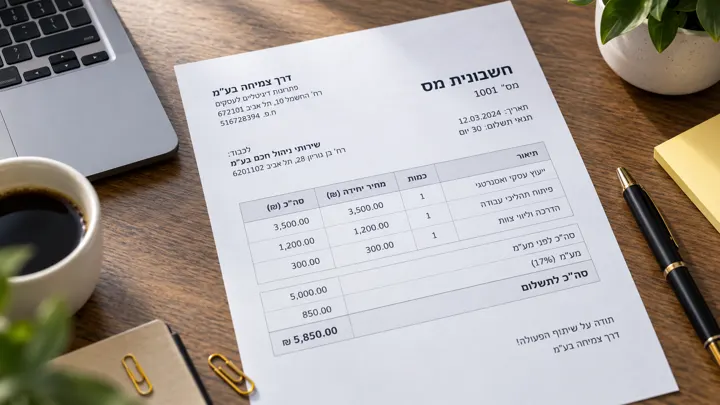
Les outils d'image par IA savent aujourd'hui modifier la photo d'un ticket de caisse en quelques secondes : changer un total, ajouter une ligne, remplacer le nom du magasin, en gardant l'aspect d'une vraie photo. Pour une équipe qui contrôle des notes de frais ou des justificatifs, le faux ne se voit plus à l'œil.
La question était simple : un détecteur open source, téléchargé et lancé tel quel, suffit il ? Nous l'avons mesuré en octobre 2026.
Le banc d'essai
Les vrais documents viennent de bases publiques de tickets de caisse, photos et scans de plusieurs pays et langues. Les faux, nous les avons fabriqués : des générateurs d'image ont reçu de vrais tickets avec des consignes réalistes écrites d'après leur texte, du type « passe le total de 38,20 à 68,20 ». Chaque faux est vérifié par OCR (le texte a bien changé) puis recalé sur son original, même cadrage et même compression, pour qu'un détecteur ne puisse pas tricher en repérant un format différent.
Le premier test compte 1 000 vrais tickets et 183 images IA. Nous avons mesuré la part de bonnes réponses et, quand elle est utile, l'AUC, qui dit si le modèle classe bien les faux au dessus des vrais : 0,5 correspond au hasard, 1 à un classement parfait.
Les six modèles, un par un
Community Forensics (ViT-S)
Score sans réglage : 51 %. Publié à CVPR 2025 par Jeongsoo Park et Andrew Owens (Owens Lab), après une prépublication en novembre 2024.
Il dit si une image entière a été générée par IA. C'est un petit réseau de vision (ViT-Small) réentraîné sur des images issues de 4 803 générateurs différents : le pari est que cette diversité l'aide à reconnaître des générateurs qu'il n'a jamais vus.
Accès. Code sur GitHub (JeongsooP/Community-Forensics), poids sur Hugging Face en deux tailles (384 et 224 pixels). PyTorch et un GPU pour les scripts d'exemple, un notebook pour tester quelques images.
Données d'entraînement. 2,7 millions d'images générées (1,1 To), publiées sous CC BY 4.0 avec la mention « usage de recherche uniquement ». Une version réduite est non commerciale.
Usage commercial. Code et poids sous licence MIT : autorisé. Le jeu de données, lui, reste ambigu.
ClipBased-SID
Score sans réglage : 50 %. Publié à CVPR Workshops 2024 par l'équipe GRIP de l'Université Federico II de Naples (Davide Cozzolino, Luisa Verdoliva et leurs collègues), avec Matthias Nießner de TU Munich.
Il dit si une image entière a été générée par IA. Il garde un grand modèle CLIP tel quel et n'entraîne qu'un petit classifieur sur ses représentations de l'image.
Accès. Code sur GitHub (grip-unina/ClipBased-SyntheticImageDetection), poids inclus dans le dépôt. GPU conseillé.
Données d'entraînement. 10 000 images réelles et 10 000 images générées par un modèle de diffusion, téléchargeables chez GRIP. Leur licence n'est pas précisée.
Usage commercial. Code sous Apache 2.0 : autorisé. Les poids n'ont pas de licence séparée, à confirmer avant usage.
DDA (Dual Data Alignment)
Score sans réglage : 52 %. Publié à NeurIPS 2025 par une équipe menée par Tencent YouTu Lab, avec plusieurs universités chinoises.
Il dit si une image entière a été générée par IA. Son idée : entraîner sur des photos réelles et leurs propres reconstructions par un autoencodeur, identiques en contenu, en taille et en compression, pour que le détecteur ne puisse apprendre que la trace de génération. Le modèle est un grand DINOv2 adapté par LoRA.
Accès. Code sur GitHub (roy-ch/Dual-Data-Alignment), poids sur Hugging Face depuis février 2026. Le script d'inférence suppose un GPU.
Données d'entraînement. Un jeu construit à partir des images de COCO, publié sous Apache 2.0.
Usage commercial. Code et poids sous Apache 2.0 : autorisé.
SuSy
Score sans réglage : 54 %. Prépublié en septembre 2024 par l'équipe HPAI du Barcelona Supercomputing Center.
Il dit si une image est synthétique et quel générateur l'a produite, parmi cinq (DALL·E 3, deux versions de Midjourney, deux variantes de Stable Diffusion). C'est un petit réseau de 12,7 millions de paramètres. Sa fiche exclut explicitement les retouches manuelles et la retouche locale.
Accès. Code sur GitHub (HPAI-BSC/SuSy), poids sur Hugging Face, démo en ligne sur Hugging Face Spaces. Le plus léger des six.
Données d'entraînement. Environ 5 400 images réelles de COCO et 18 000 images synthétiques, sous des licences qui varient selon la source.
Usage commercial. Code et poids sous Apache 2.0 : autorisé, avec une restriction écrite : ne pas s'en servir pour entraîner des outils destinés à le tromper.
NPR
Score sans réglage : 50 %. Publié à CVPR 2024 par Chuangchuang Tan et ses collègues (Beijing Jiaotong University, YanShan University, A*STAR).
Il dit si une image entière a été générée par IA, en cherchant les relations entre pixels voisins que laissent les couches d'agrandissement des générateurs.
Accès. Code et poids sur GitHub (chuangchuangtan/NPR-DeepfakeDetection), démo sur Hugging Face Spaces. Dépendances légères, mais un environnement recommandé ancien (PyTorch 1.8).
Données d'entraînement. Quatre catégories (voitures, chats, chaises, chevaux) d'un jeu de recherche de 2020 : photos réelles et images générées par ProGAN, un générateur d'ancienne génération.
Usage commercial. Aucun fichier de licence dans le dépôt : sans licence, aucun droit d'usage n'est accordé.
TruFor
Score sans réglage : 62 % (AUC 0,56). Publié à CVPR 2023 par l'équipe GRIP de Naples (Fabrizio Guillaro, Davide Cozzolino, Luisa Verdoliva), avec Avneesh Sud et Nicholas Dufour.
Contrairement aux cinq autres, il cherche les retouches locales dans une photo et rend une carte de la zone suspecte, un score global et une carte de fiabilité. Il compare l'image à l'empreinte de bruit laissée par l'appareil photo : une retouche apparaît comme un écart à cette empreinte.
Accès. Code sur GitHub (grip-unina/TruFor), poids à télécharger chez GRIP, installation par Docker, fonctionne aussi sans GPU. Le code d'entraînement est publié depuis mars 2025.
Données d'entraînement. Plusieurs jeux publics de falsifications classiques (CASIA 2.0, IMD2020, FantasticReality, et d'autres).
Usage commercial. Non commercial : la licence réserve le logiciel à un usage « informatif et non lucratif » et interdit toute activité industrielle ou commerciale.
En résumé
TruFor a été mesuré ensuite sur un test plus large de 2 819 images : sur les mêmes faux, il n'en reconnaît que 38 %, et il signale à tort plus d'un vrai ticket sur quatre.
Pourquoi ces scores sont si faibles
Ces modèles ont été entraînés sur des photos naturelles : visages, paysages, scènes de rue. Un ticket de caisse est une image très différente, du texte noir sur un papier clair, souvent photographié de travers et compressé plusieurs fois. Ce qu'ils ont appris ne s'y transpose pas.
Chaque famille a sa raison d'échouer. Les détecteurs qui réduisent l'image entière à 224 ou 384 pixels, comme ClipBased-SID, perdent en route les traces fines que laissent les générateurs. TruFor est conçu pour repérer un collage dans une photo : face à un ticket entièrement régénéré, sa carte d'anomalie s'allume sur 98 % des images, vraies comme fausses. NPR cherche les traces d'agrandissement des générateurs, que la recompression JPEG d'une vraie photo efface en grande partie.
Et les grands modèles de langage ?
Question naturelle : pourquoi ne pas demander directement à un LLM si l'image est fausse ? Nous l'avons fait sur 300 images, la moitié vraies, la moitié fausses :
Les LLM lisent le texte : ils repèrent une addition fausse ou un nom incohérent. Quand le faussaire a recalculé le total proprement, ils ne voient presque plus rien. Claude Sonnet 4.5 répond « authentique » presque à chaque fois ; Gemini 2.5 Pro est le meilleur des quatre, au prix de 9 % de fausses alertes.
Notre avis sur la question
Aucun détecteur public ne se lance tel quel sur des documents. Pour qu'il serve, il faut le réentraîner sur des documents, vrais et faux, et surtout sur des faux réalistes : des retouches d'un seul montant, pas seulement des images entièrement inventées. C'est le chemin que nous avons suivi chez Koncile pour notre propre modèle.
Même réentraîné, un détecteur d'images a ses limites : une retouche très locale, de quelques dizaines de pixels, reste difficile à voir, et les retouches classiques sans IA ne laissent pas la même texture. L'analyse de l'image n'est donc qu'un indice parmi d'autres, à côté des métadonnées, de la structure du fichier et de la cohérence des montants, jamais un verdict à elle seule.
Questions fréquentes
Peut-on détecter une image générée par IA avec un modèle open source gratuit ?
Sur des documents, rarement tel quel : dans nos tests, les six détecteurs publics essayés répondent au niveau du hasard sur des tickets de caisse. Ils doivent être réentraînés sur des documents pour devenir utiles.
Quel détecteur open source fonctionne le mieux sans réglage ?
Dans nos tests, aucun : TruFor fait le meilleur score avec 62 % de bonnes réponses, mais son AUC de 0,56 montre qu'il classe les faux presque au hasard.
ChatGPT ou Gemini peuvent-ils dire si un document est faux ?
Ils repèrent les incohérences de texte, pas les traces dans les pixels. Sur des retouches d'un seul montant, ils détectent entre 8 % et 56 % des faux.
Les poids de ces modèles sont-ils utilisables commercialement ?
Pas tous. Community Forensics (MIT), DDA et SuSy (Apache 2.0) l'autorisent ; TruFor l'interdit ; NPR n'a aucune licence, donc aucun droit d'usage. Vérifiez toujours le fichier de licence du code et celui des poids avant un usage en production.